Jev, Laya e a Revolução dos Modelos System 1: Por Que o Futuro dos Agentes Não São Chatbots Maiores, Mas Decisões de 30ms
A ascensão do Jev e do Laya inaugurou a era dos modelos de resposta tipada. Entenda como arquiteturas em cascata reduzem custos, eliminam latência e transformam operações de CRM e vendas.

Jev, Laya e a Revolução dos Modelos System 1: Por Que o Futuro dos Agentes Não São Chatbots Maiores, Mas Decisões de 30ms
Durante os últimos três anos, a indústria de tecnologia operou sob um dogma quase unânime: para resolver problemas mais difíceis com inteligência artificial, você precisa de modelos maiores, mais parâmetros e janelas de contexto gigantescas.
Na prática das empresas, no entanto, essa abordagem criou uma aberração arquitetural. Companhias passaram a enviar qualquer evento trivial — como decidir se um e-mail de cliente é spam, se um ticket de suporte é urgente ou se um lead no WhatsApp quer falar sobre preço — para modelos generativos com centenas de bilhões de parâmetros, pagando faturas astronômicas de API e esperando 2 a 4 segundos por resposta.
O lançamento do Jev e, poucos dias depois, a explosão de equivalentes open source liderada pelo Laya, expôs publicamente a fragilidade dessa abordagem.
Eles não vieram para ser "mais inteligentes" que o Claude ou o GPT. Vieram para fazer exatamente o oposto: tomar decisões estruturadas em alta velocidade por uma fração do custo.
---
1. O Que São Modelos System 1 (E Por Que Eles Não São Chatbots)
Na psicologia comportamental, Daniel Kahneman cunhou a distinção entre:
Até hoje, quase toda a pilha de agentes autônomos foi construída forçando modelos System 2 (como GPT-4o, Claude 3.5 Sonnet ou Gemini Pro) a realizarem tarefas de System 1.
ARQUITETURA ANTIGA (INEFICIENTE):
[Mensagem do Lead] ──> [LLM Gigante (GPT/Claude)] ──> [Gera JSON token por token] ──> [Espera 3s / $0.02]
ARQUITETURA MODERNA (CASCATA SYSTEM 1):
[Mensagem do Lead] ──> [Modelo System 1 (Laya/Jev)] ──> [Decisão em 30ms / $0.00] ──> [Ação Imediata]
                                   │
                     (Se o caso for de alta complexidade)
                                   └──> [Chama Frontier Model (Claude/GPT)]
O Problema da Geração Autorregressiva
LLMs generativos geram texto token por token. Quando você pede para um chatbot responder um JSON com{"urgente": true}, o modelo precisa:
Modelos como Jev e Laya são não-autorregressivos, frequentemente construídos sobre backbones de encoders de altíssima eficiência como o ModernBERT. Eles não geram prosa livre: recebem o estado e retornam uma resposta tipada em uma única passada (single forward pass):
---
2. A Comoditização em 7 Dias: De Jev ao Ecossistema Open Source
Quando a TypeSafe AI lançou o Jev, muitos no mercado acreditaram que estavam diante de um novo monopólio de infraestrutura para agentes autônomos. Ele entregava decisões probabilísticas estruturadas via API com latência na casa dos 250ms.
Porém, em questão de uma semana, a comunidade open-source e laboratórios independentes desconstruíram a tese de exclusividade:
| Modelo / Projeto | Desenvolvedor / Base | Licença | Arquitetura / Parâmetros | Latência Típica |
|---|---|---|---|---|
| Jev | TypeSafe AI | Fechada (Cloud API) | ModernBERT Backbone | ~230–270 ms (Rede + API) |
| Laya | Convai Innovations | Open Source (Apache 2.0) | ModernBERT (421M params) | ~33 ms (Local / T4) |
| Von | Open Community | Apache 2.0 | 395M params | ~30 ms |
| OpenJev | Comunidade | Open Source | Baseado em DiffusionGemma | ~40 ms |
| SemIf / djev / Kev | Vários experimentos | Apache 2.0 / MIT | Variados (MLX / ONNX) | 10–50 ms em Apple Silicon |
---
3. A Arquitetura em Cascata: Como Aplicar na Prática
A grande lição dessa transição não é que você deva jogar fora o Claude ou o GPT, nem que deva escolher cegamente apenas o Laya.
A arquitetura que está se tornando o padrão da engenharia de IA de ponta é o Roteamento Especulativo em Cascata (Cascading Decision Architecture):
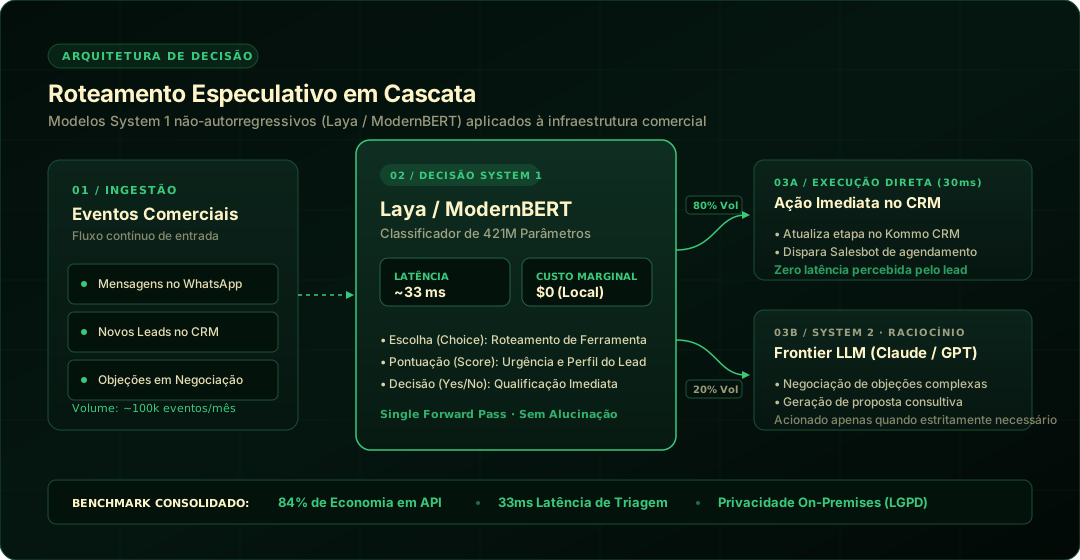
                            [ENTRADA DO EVENTO]
                       (Mensagem, Lead, Ticket, Log)
                                     │
                                     ▼
                    ┌─────────────────────────────────┐
                    │  Camada 1: Decisão Rápida Local │
                    │      (Laya / 421M / 30ms)       │
                    └─────────────────────────────────┘
                                     │
                    ┌────────────────┴────────────────┐
                    ▼                                 ▼
         [Confiança Alta ≥ 92%]             [Confiança Média / Baixa]
                    │                                 │
                    ▼                                 ▼
        ┌───────────────────────┐         ┌─────────────────────────┐
        │ Executa Imediatamente │         │   Camada 2: Raciocínio  │
        │ - Roteia no CRM       │         │    (Claude 3.5 / GPT)   │
        │ - Dispara Ferramenta  │         └─────────────────────────┘
        │ - Bloqueia Spam       │                     │
        └───────────────────────┘                     ▼
                                          ┌─────────────────────────┐
                                          │  Resposta Deliberada    │
                                          │   Negociação Complexa   │
                                          └─────────────────────────┘
Por que essa cascata é revolucionária?
Simulação Prática de ROI: Operação Comercial B2B com 100.000 Eventos/Mês
Para visualizar o impacto financeiro e operacional, considere uma empresa B2B processando 100.000 mensagens e interações mensais de leads entre WhatsApp, formulários e CRM:
| Dimensão Operacional | Abordagem Antiga (LLM Frontier Direto) | Arquitetura em Cascata (Laya + Claude) | Diferença Real |
|---|---|---|---|
| Pilha Tecnológica | Claude 3.5 Sonnet / GPT-4o em 100% dos eventos | Laya local (80% dos eventos) + Frontier (20%) | Infraestrutura Híbrida |
| Latência Média de Resposta | 2.200 ms a 3.800 ms (2 a 4 segundos) | 33 ms (Laya) / 2.500 ms (apenas casos complexos) | -85% no tempo de espera |
| Custo de Tokens / Mês | ~$2.000 a $2.500 USD (~R$ 13.000/mês) | ~$250 a $400 USD (~R$ 2.000/mês) | Economia de até 84% em API |
| Risco de Alucinação em Triagem | Alto (geração livre token por token) | Zero (classificação tipada determinística) | Previsibilidade e Segurança |
| Privacidade de Dados Críticos | 100% dos dados enviados para nuvem pública | 80% resolvido on-premises / air-gapped | Compliance LGPD Superior |
4. Aplicações Comerciais e B2B Dentro da EverGreen
Dentro dos produtos e consultorias de engenharia comercial da EverGreen, estamos utilizando exatamente essa lógica para transformar a forma como empresas B2B operam:
4.1. Triagem e Qualificação de Leads em Tempo Real no CRM (Kommo / WhatsApp)
Em vez de depender de um prompt pesado lendo cada conversa do WhatsApp, um modelo de decisão System 1 lê a mensagem do prospect e responde de imediato:4.2. Copiloto de Objeções para Vendedores
Durante uma negociação ou troca de mensagens, o modelo avalia o tom do cliente e a objeção levantada (ex: "Achei a implantação muito longa"). Em menos de 50 milissegundos, o copiloto sugere na tela do vendedor a prova social e o contra-argumento técnico exato do playbook da empresa.4.3. Roteamento Dinâmico de Ferramentas e Skills de Agentes
Em sistemas com múltiplos agentes autônomos, o maior gargalo costumava ser o agente "pensar demais" para escolher qual ferramenta chamar. Modelos como Laya resolvem a escolha da tool como um vetor de classificação fechado, reduzindo o tempo total de execução dos fluxos autônomos pela metade.---
5. Aonde Está o Verdadeiro "Moat" (Diferencial Competitivo)?
Se um modelo de decisão de ponta pode ser clonado, treinado em ModernBERT e distribuído em código aberto em uma semana, fica evidente uma verdade desconfortável para o mercado de IA:
O modelo em si não é um fosso competitivo (moat). Modelos de decisão tornaram-se commodities de infraestrutura.
Onde, então, reside o valor duradouro?
A velocidade da inteligência artificial continuará assustadora. Aqueles que tentarem construir empresas dependendo unicamente de um modelo de terceiros serão engolidos pela comoditização. Aqueles que utilizarem esses novos primitivos para orquestrar sistemas robustos de negócios estarão construindo o futuro.

Eduardo Mattos
Fundador & Estrategista Comercial EverGreen
A EverGreen é uma boutique de engenharia comercial e tecnologia sediada no Brasil, especializada no método Sistema Raiz para previsibilidade e escala B2B.
Gostou da metodologia? Destrave seus gargalos de vendas.
Solicite um Raio-X Comercial com nossos especialistas e descubra onde a sua esteira de vendas está perdendo receita e cadência.
Artigos Técnicos Recomendados
4 Casos Reais de Automação Comercial com IA no WhatsApp e CRM: Do Roteamento de 30ms ao Fechamento
Veja na prática como operações B2B utilizam IA de decisão e modelos em cascata para qualificar leads no WhatsApp, reduzir tempo de resposta e destravar faturamento.
IA Aplicada ao Comercial B2B: Além do ChatGPT — Arquitetura de Agentes para Qualificação e Follow-Up
Usar o ChatGPT para redigir e-mails não é estratégia de IA. Descubra como arquiteturas de agentes autônomos mudam a produtividade de operações comerciais complexas.
Kommo CRM em 2026: Guia Técnico de Implementação, Salesbots e WhatsApp B2B
Centralizar o WhatsApp da sua equipe no Kommo é apenas o primeiro passo. Descubra como desenhar pipelines, configurar salesbots contextuais e eliminar o caos de conversas perdidas.